왜 디자인이 비슷할 수 있나
공통 과제에서 흰색·남색·청록 팔레트, 제목·본문 크기, 10장 구성, native 차트 2개와 표 2개 이상을 미리 지정했습니다. 작성 경로도 모두 GenOffice ops로 고정했습니다. 이 설계가 스킬별 차이를 제한할 수 있으므로, 외형의 유사성을 스킬 효과가 없다는 결론으로 연결하지 않습니다.
같은 Hermes, 같은 Gemma, 같은 10장 과제. 네 가지 스킬 조합의 실제 결과를 같은 슬라이드끼리 나란히 비교합니다.
네 조건 모두 GenOffice CLI로 PPTX를 직접 작성하도록 지시했습니다. Baseline에도 동일한 CLI 안내와 과제를 주고, 나머지 조건에만 해당 스킬 본문을 처음부터 제공했습니다. Claude PPTX는 스킬 이름이며, 생성 모델은 모든 조건에서 Gemma입니다.
| 조건 | 실행 상태 | 생성 장 수 | Native 차트 | 표 객체 / 내용 있음 | 실행 시간 | 모델 호출 | 입력 / 출력 토큰 | 기록 비용 |
|---|---|---|---|---|---|---|---|---|
| Baseline | 종료 | 10/10 | 2 | 2 / 2 | 403초 | 32 | 1,002,502 / 20,581 | $0.089204 |
| GenOffice | 종료 | 10/10 | 2 | 2 / 2 | 248초 | 10 | 406,586 / 11,482 | $0.039418 |
| GenOffice + Claude | 종료 | 10/10 | 2 | 2 / 2 | 388초 | 18 | 1,057,736 / 19,107 | $0.098927 |
| Claude PPTX | 종료 | 10/10 | 2 | 2 / 0 | 1740초 | 32 | 2,335,785 / 78,294 | $0.256915 |
시간은 격리 환경 준비부터 native run 종료까지이며 렌더 검수 시간은 제외합니다. 비용은 OpenRouter 응답 usage.cost 합계(USD)입니다. 응답 또는 비용 기록이 빠진 호출이 있으면 전체 비용은 미기록으로 표시하며 공개 JSON에 확인된 부분 합계와 미기록 건수를 남깁니다. 실행 종료는 내용 품질 통과를 뜻하지 않습니다. 차트·표는 PPTX 내부 객체로 확인했으며 PowerPoint에서 직접 편집하는 검증까지 뜻하지 않습니다.
2026년 10월 22일, 원시 모델 요청·도구 호출·반환 결과와 Langfuse trace를 다시 대조했습니다. 두 스킬의 본문은 해당 조건에 전문으로 전달됐습니다. 하지만 공통 지침이 스킬별 작성 경로를 덮어썼고, 생성 모델이 렌더 이미지를 보고 수정하는 순환은 없었습니다.
| 확인 항목 | Baseline | GenOffice | GenOffice + Claude | Claude |
|---|---|---|---|---|
| 첫 시스템 메시지에 스킬 전문 포함 | 미제공 | GenOffice 확인 | 두 본문 모두 확인 | Claude 확인 |
| GenOffice design/spec 가이드·단계별 설계 | 해당 없음 | 공통 지침으로 제외 | 공통 지침으로 제외 | 해당 없음 |
| Claude PptxGenJS 작성 | 해당 없음 | 해당 없음 | 공통 지침으로 제외 | 공통 지침으로 제외 |
| Claude 필수 validate.py 실행 | 해당 없음 | 해당 없음 | 0회 | 0회 |
| GenOffice 기하학적 audit 명령 | 4회 | 1회 | 1회 | 0회 |
| 실행 중 렌더 산출물 확인 | PDF 생성 | 앱 실행 오류로 실패 | PDF + 10장 이미지 생성 | 렌더 호출 없음 |
| 생성 모델에 슬라이드 이미지 재입력 | 0건 | 0건 | 0건 | 0건 |
| 별도 검증자의 종료 후 이미지 렌더 | 10장 | 10장 | 10장 | 10장 |
공통 과제에서 흰색·남색·청록 팔레트, 제목·본문 크기, 10장 구성, native 차트 2개와 표 2개 이상을 미리 지정했습니다. 작성 경로도 모두 GenOffice ops로 고정했습니다. 이 설계가 스킬별 차이를 제한할 수 있으므로, 외형의 유사성을 스킬 효과가 없다는 결론으로 연결하지 않습니다.
GenOffice 앱 렌더는 실행 경로 권한 오류로 실패했습니다. 결합 조건은 Claude 렌더 스크립트의 잘못된 상대경로를 고친 후 이미지 생성에 성공했지만 모델에 이미지를 입력하지 않았습니다. 스크립트는 설치되어 있었습니다. 외부 검증자가 본 이미지는 생성 모델의 검수·수정 수행 증거가 아닙니다.
모든 조건에 같은 사용자 과제와 공통 환경 지침을 주었습니다. 조건별 차이는 처음 시스템 메시지에 추가한 SKILL.md 본문입니다. 스킬의 탐색·선택·동적 로딩 기능은 이 실험에서 측정하지 않았습니다. 스킬 전문은 배포하지 않으며 버전과 SHA256은 감사 JSON에서 확인할 수 있습니다.
판정: CLI 제약 아래의 스킬 본문 추가 파일럿. 원래 스킬 워크플로를 충실하게 실행한 비교로 분류하지 않습니다. 실제 결과 파일은 수정하지 않고 보존했습니다. 도구 명령 횟수는 시도 횟수이며 성공 횟수와 다를 수 있습니다. Langfuse 재조회: 2026-10-22 16:00 KST, 환경 hermes-migration-validation.
이미지를 누르면 크게 볼 수 있습니다. 확대 화면에서 조건과 장을 바꿀 수 있습니다. 작은 화면에서는 비교 영역을 가로로 스크롤하세요.
10장과 native 차트 2개·표 2개를 만들었고 차트의 원시 수치는 과제와 일치합니다. 남색·청록색으로 계획과 실적이 구분됩니다. 큰 겹침은 보이지 않지만 본문 영역이 작고 빈 공간이 큽니다. 잔여 434억원을 계획 열에 넣어 의미가 모호하며 증액 세부 8.4·4.1·1.7억원은 빠졌습니다. 시정률 89.3%는 25/28을 올바르게 반올림했습니다.
10장과 native 차트 2개·표 2개를 생성했습니다. 큰 겹침은 보이지 않으나 넓은 빈 공간과 작은 차트 범례가 남았습니다. 계획·실적이 같은 청록색 계열이라 구분이 약합니다. 지연 일수 중복 미확인과 승인 대기는 보존했지만, 잔여 사업비 434억원, 증액 세부 8.4·4.1·1.7억원, 협력사 개선 과제는 빠졌습니다.
10장과 native 차트 2개·표 2개를 만들었습니다. 원가 세부항목과 협력사 개선 과제를 포함했고 차트 원시 수치는 일치합니다. 그러나 7장에 “재검측 발생 4건 (즉시 보완 및 조치 완료)”를 추가했습니다. 입력에는 완료 근거가 없어 사실성 오류입니다. 텍스트 위주의 반복 구도와 작은 차트 범례도 남았습니다.
10장과 native 차트 2개·표 객체 2개를 생성했지만 8장 원가 표와 9장 협력사 표의 셀 내용이 모두 비어 있습니다. 누계 510·486·472억원과 잔여 434억원, 팀 평가 내역을 결과에서 확인할 수 없습니다. 차트 원시 수치는 일치합니다. 반복된 CLI·슬라이드 인덱스 오류 복구에 약 29분이 걸렸고, native run의 완료 응답과 실제 내용 완성도가 일치하지 않았습니다.
Gemma → Hermes native terminal → ego-browser 경로로 로컬 폼을 열고, 현장명 입력·분기보고 선택·제출·완료 DOM 확인·화면 캡처를 수행했습니다. 서버 수신값도 대조했습니다.
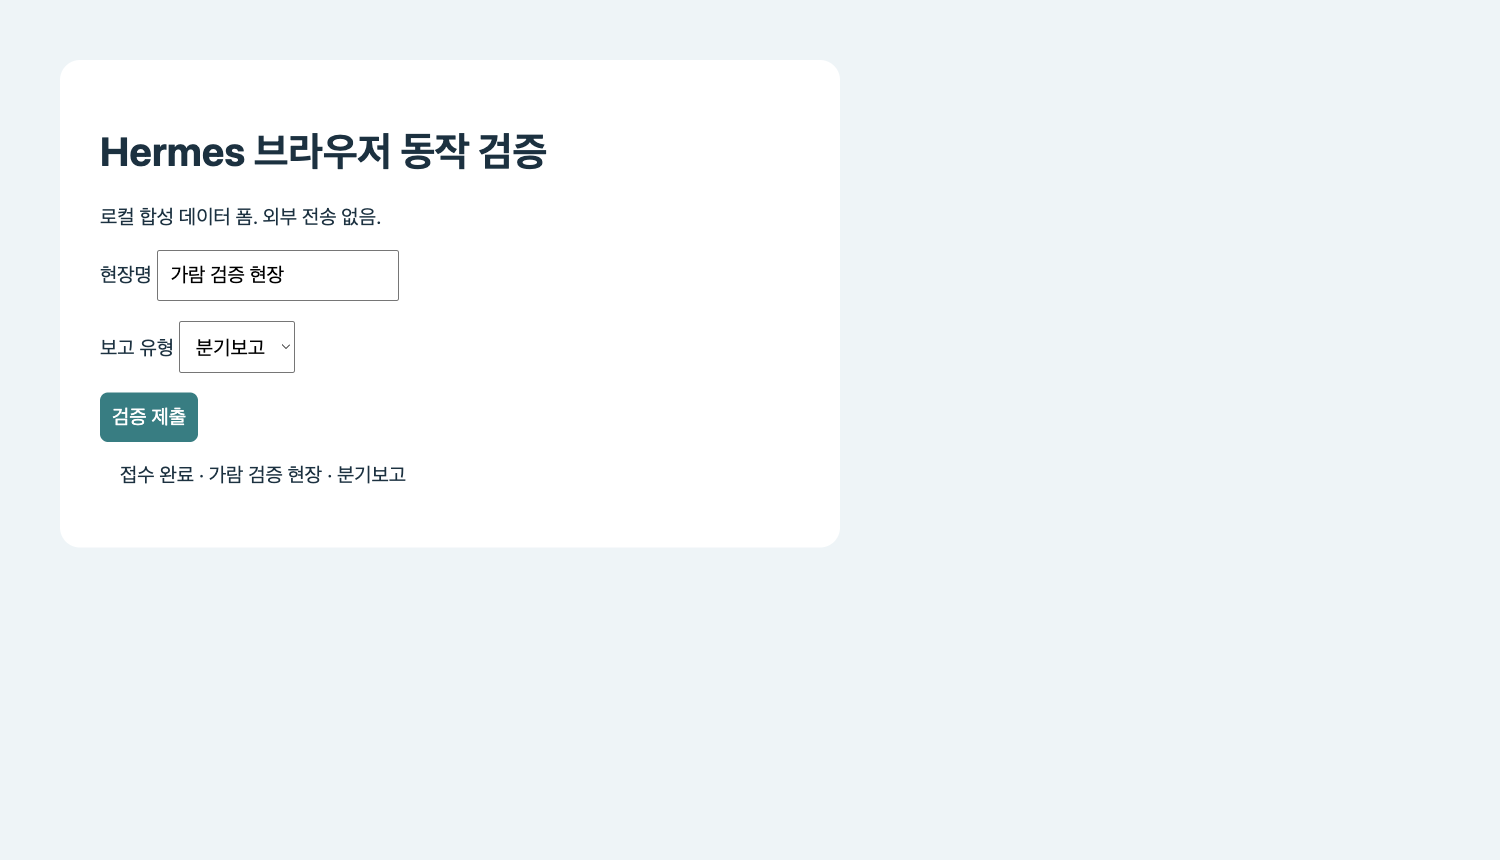
Desktop 호스트 경로 검증입니다. 격리된 서버 컨테이너와 사용자 브라우저를 연결하는 제품 기능 전체를 통과한 것은 아닙니다.
Gemma가 Hermes native image_generate를 호출했습니다. 설정된 Qwen Image 3로 원본을 만든 뒤, 그 파일을 참조하여 안전모 색상을 바꾸는 편집을 요청했습니다.
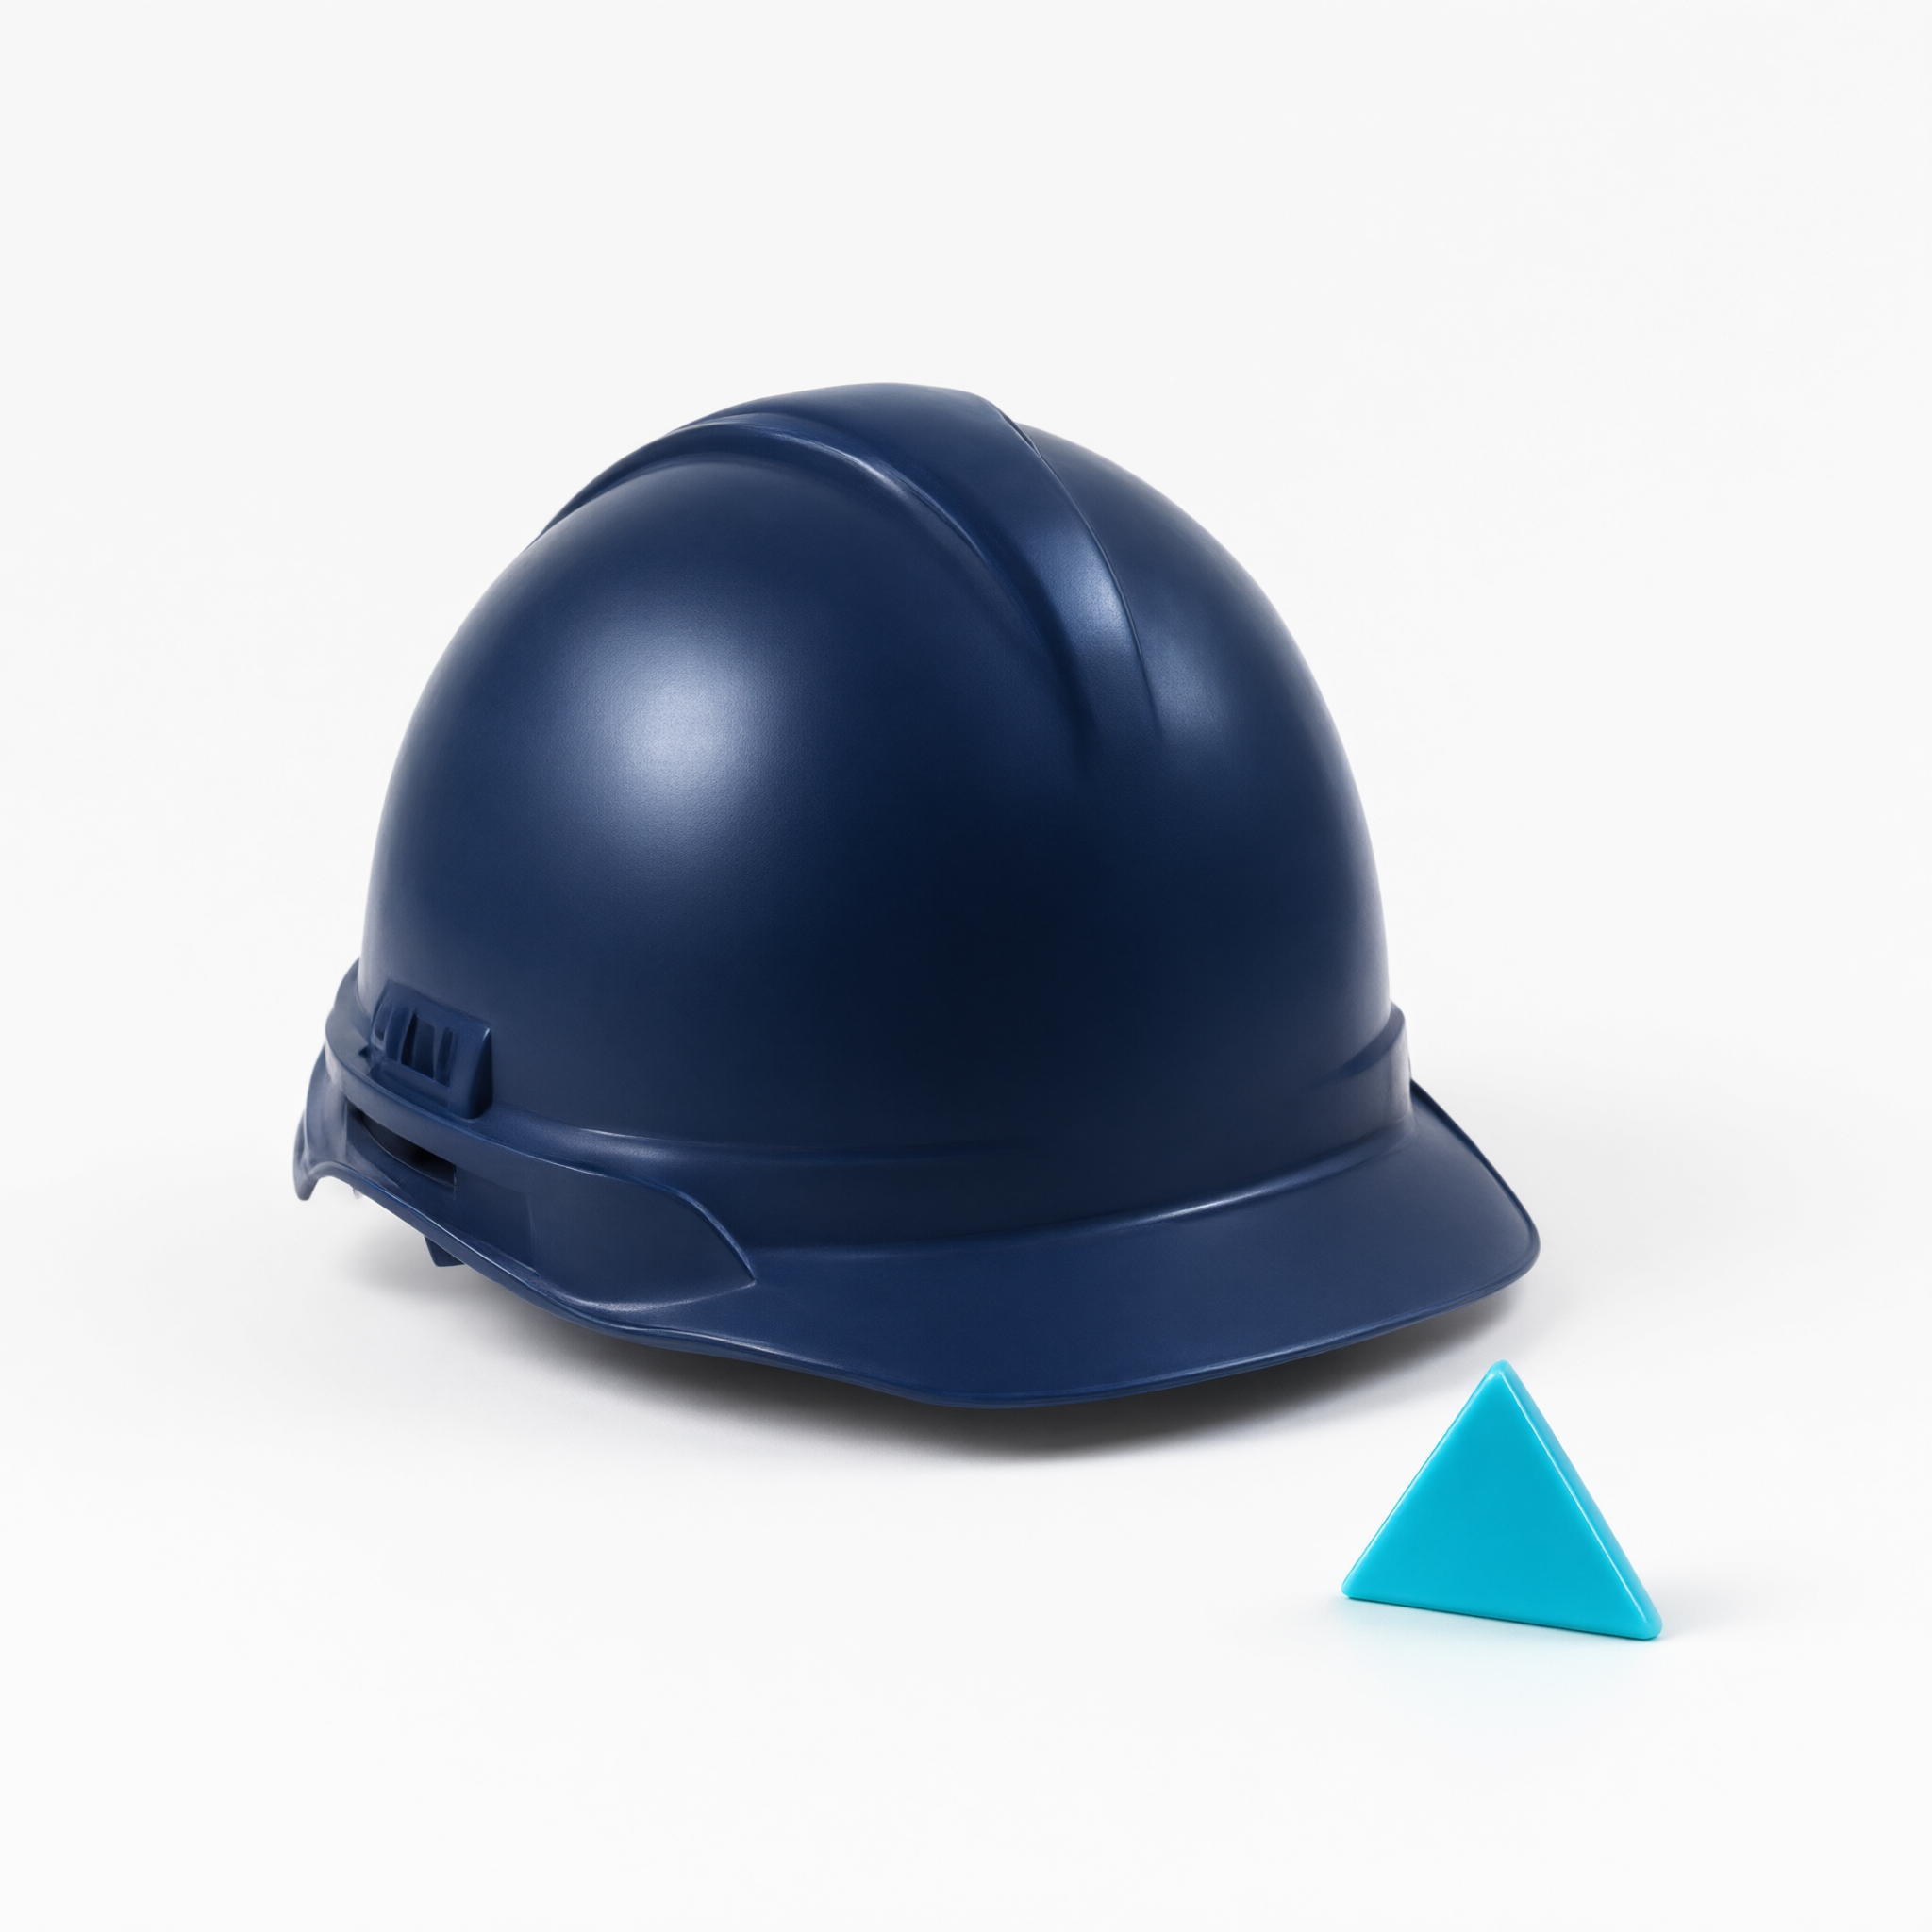
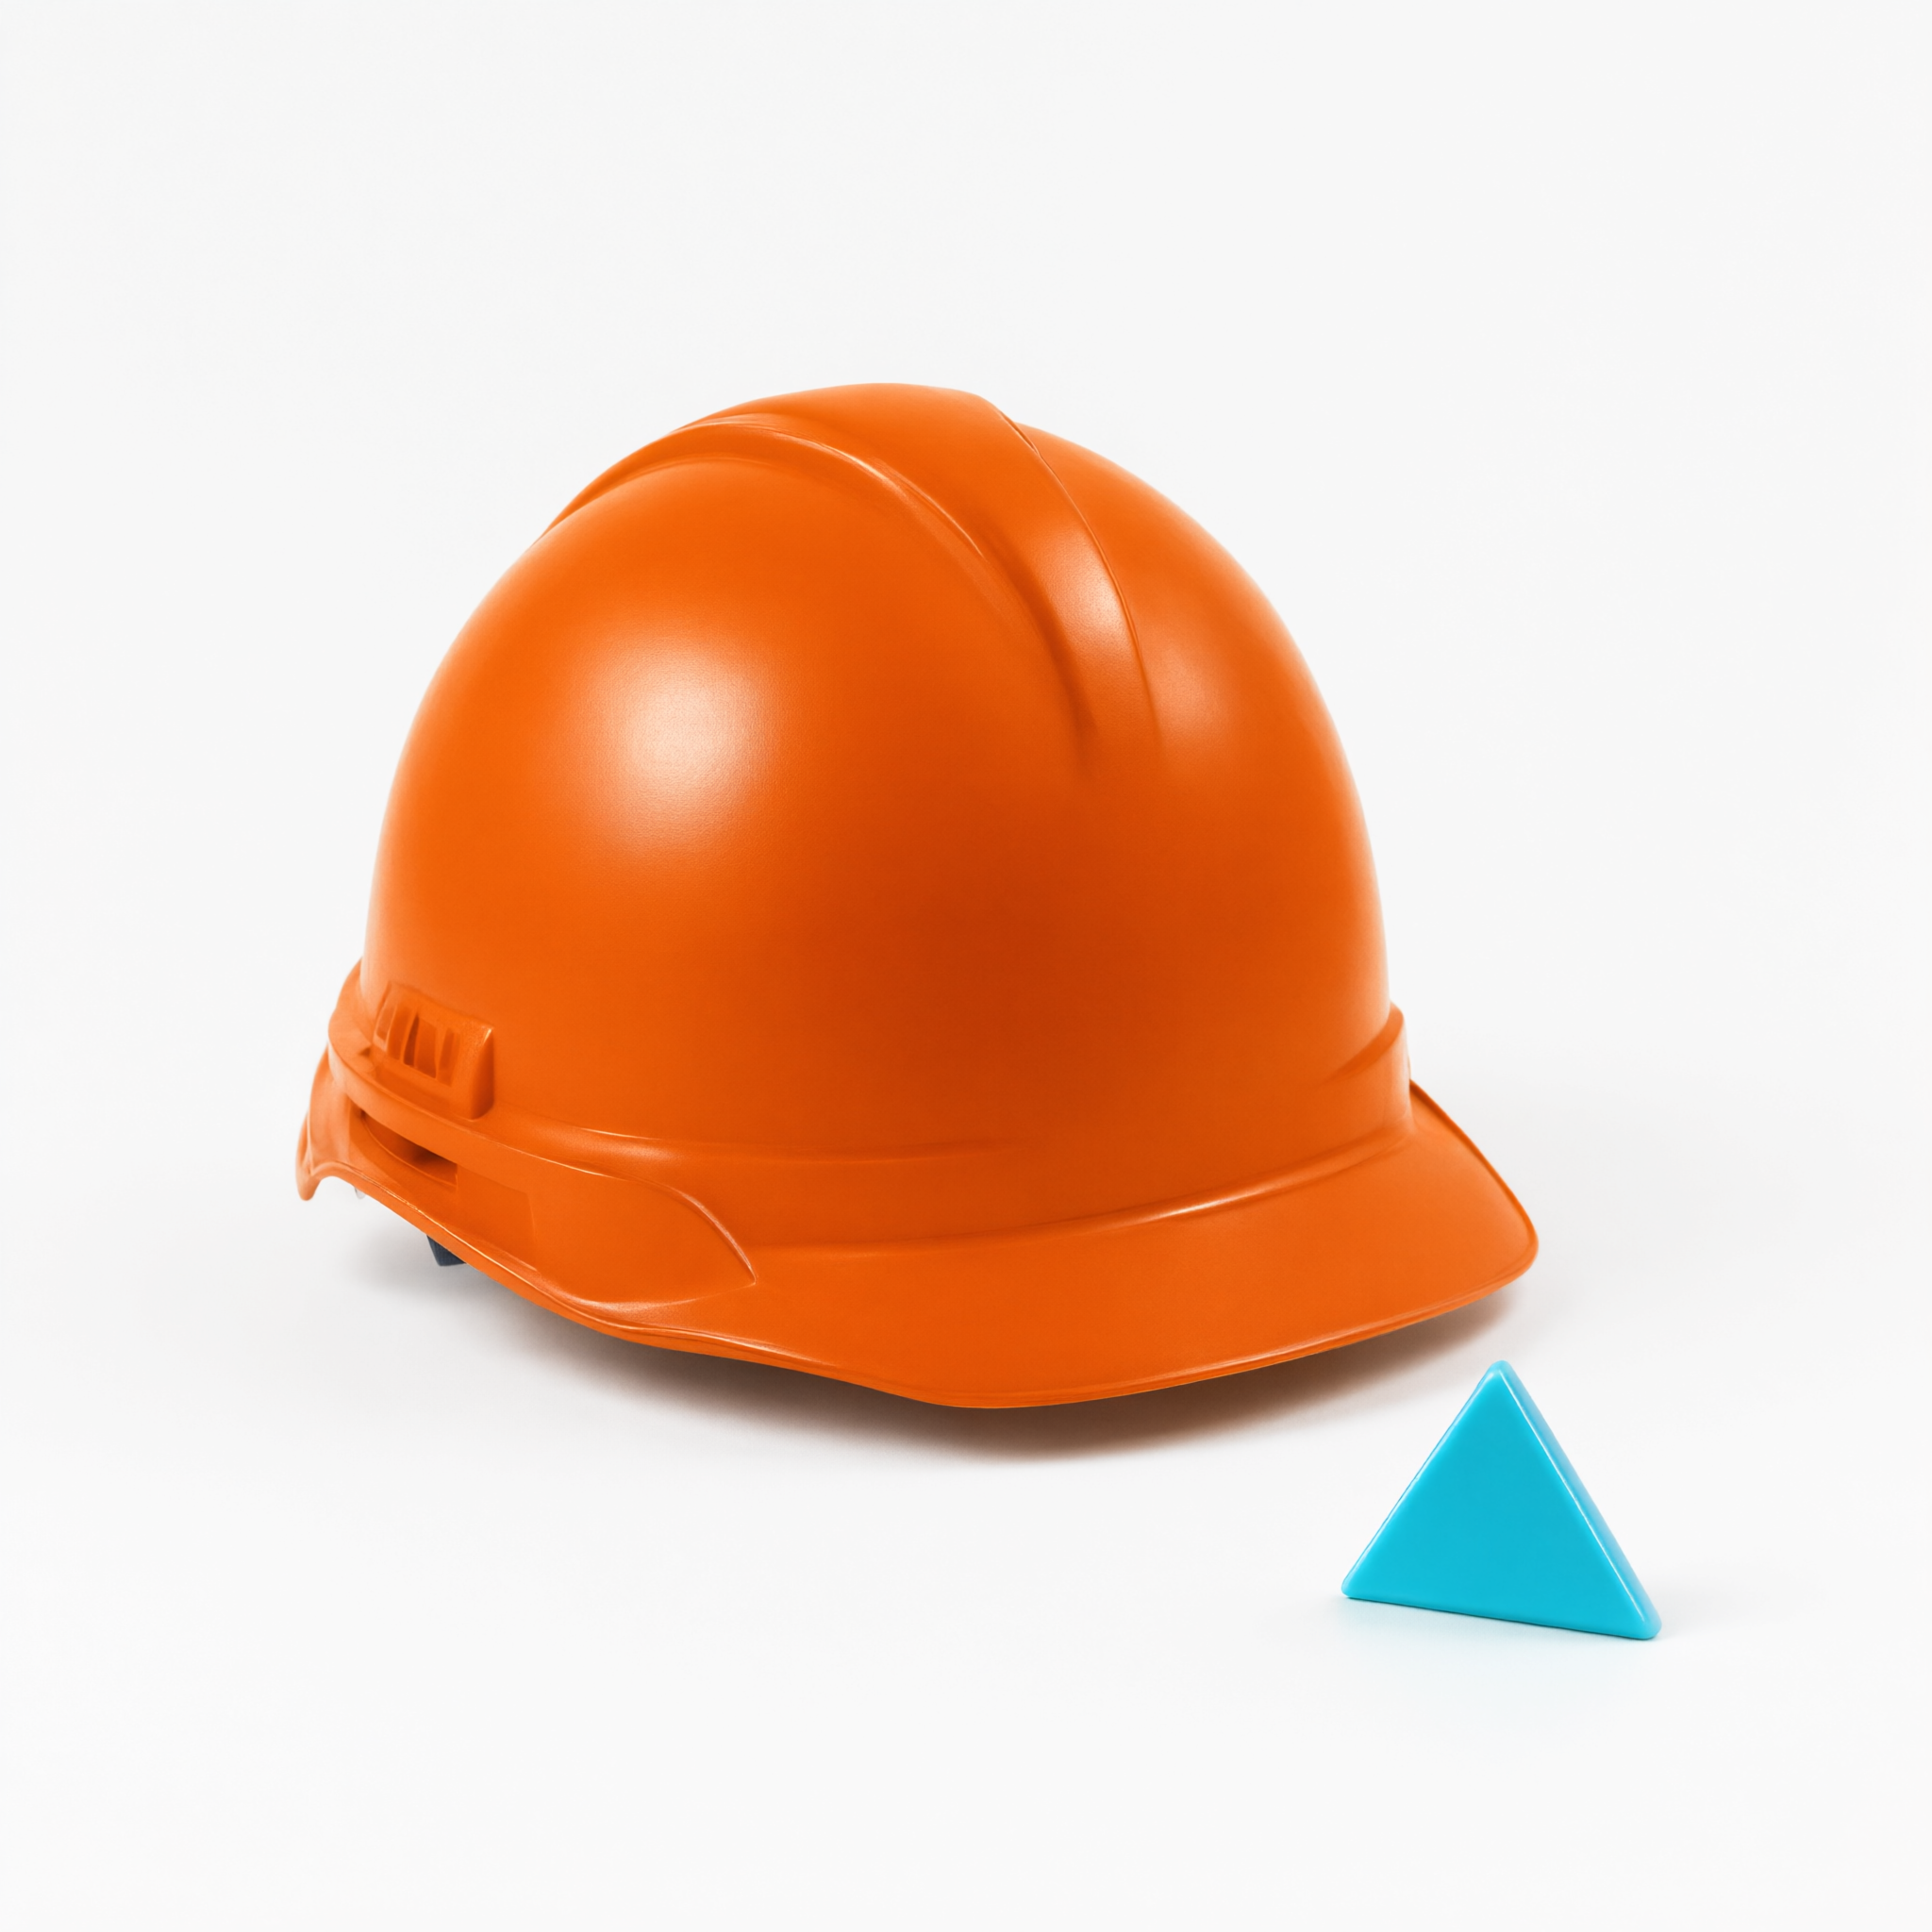
실제 이미지 2개를 확인했습니다. 남색 안전모가 주황색으로 바뀌었고 흰 배경·청록색 삼각형·구도는 대체로 유지됐습니다. 편집 요청의 input_references에 원본 파일이 실렸으며 단순 재생성으로 대체하지 않았습니다. 이미지 제공자 기록 비용은 생성 $0.030, 편집 $0.033입니다(Gemma 도구 지시 비용 별도).
고정: Hermes 835c3dd, google/gemma-4-31b-it, GenOffice CLI 0.10.0, 같은 한국어 합성 브리프, 16:9 10장, native chart 2개·native table 2개 이상. reasoning_effort=medium과 응답 상한 8,192 토큰을 공통 적용했고, temperature는 지정하지 않았습니다. 각각 독립 home·세션·파일 볼륨을 사용했고 2 CPU / 2 GiB 제한으로 동시 실행했습니다. 과거 메모리와 다른 PPT 스킬 본문은 로드하지 않았습니다. 사용자 과제와 도구 스키마의 해시가 네 조건에서 동일함을 확인했습니다. 공통 실행 한도는 30분, 모델 호출 한도는 80회입니다.
변경: 처음 시스템 지시에 제공한 PPT 스킬 본문만 바꿨습니다. GenOffice 스킬 2.67.1과 기존 Claude PPTX 스킬을 사용했습니다. 공통 사용자 지시에 따라 스킬의 중간표현 pipeline 및 PptxGenJS 작성 절차는 적용하지 않았습니다. 이는 해당 제약 아래의 스킬 조합 실험입니다.
기존 참고 보고서와 모델·과제·Hermes 버전이 달라 그 보고서의 점수와 직접 비교하지 않습니다. 첫 파일럿에는 별도로 작성한 가람 합성 과제를 사용했습니다. 참고 보고서에는 사용자 질문 원문과 입력 조건이 공개되어 있으며, 이전의 “원본 과제 미공개” 설명을 정정합니다. 참고한 비교 보고서
Native run의 종료 상태, 모델 응답 usage, 도구 이벤트, 실제 PPTX 패키지의 차트·표·텍스트와 렌더 이미지를 대조했습니다. 렌더 이미지로 글자·구도·가림을 확인하고, 차트 원시 값과 승인 대기 표현을 원문과 비교했습니다. 렌더러 차이, 반복 실행 변동성, 실제 업무 자료, PowerPoint 실제 편집, Windows 환경은 이 파일럿의 검증 범위 밖입니다.
모델 호출은 Langfuse에 수집하고 native 도구 이벤트는 로컬 원장에 보존했습니다. 제품 운영 경로 전체의 tracing 통과를 뜻하지 않습니다. API 키, 환경 파일, 원문 모델 로그와 스킬 전문은 공개 디렉터리에 포함하지 않았습니다.
run_f57b9406092443c5a43abb87c6dd2878 · trace 98d089c7ba2d7bd152b7e03b39068326run_59f54d061f1348c78c2debbb4d1309d4 · trace a1d31eff66fc816272a12b0d5735a78arun_ecb2f062e82e4adaabd0f8fc720f5573 · trace f798bf55f7d949ec648e536332fe039erun_ceec8402ee8d4f748c9331adcd410bef · trace 12e8c184ed0fd24baf4262a1849c4252공개용 측정 결과 JSON · 구조·수치 대조 JSON · 입력 통제 대조 JSON · 동일 과제 원문 · 실험 보고서 Word · 실험 보고서 원문